09.07.2026
從世界模型到 Physical AI:用 NVIDIA Cosmos 3 為 AIDC 巡檢建立測試資料
你將了解的內容
- 世界模型如何補足 Physical AI 的測試資料
- 如何用 Cosmos 3 一次生成影片與聲音,以及三組樣本的提示詞怎麼寫
- 如何把資料生成、視覺判讀與聲音分析接成一套流程,並讓判讀端看不到答案
1. 先有測試資料,才談得上巡檢效果
Physical AI 要進入 AIDC 巡檢,在檢查模型判讀得準不準之前,先要有足夠的資料反覆測試。冒煙、積水、機櫃起火等明顯異常不難展示;難處在於不起眼的狀態變化,例如一整排綠燈裡有一顆變成琥珀色、少了一片盲板、機櫃門沒有關緊,或螢幕上出現一行警告。
要有系統地蒐集這些素材並不容易。Cosmos 3 可以先生成指定情境,補上少見或難以安排的測試案例。我們因此建立一組可重複使用的合成樣本,作為正式進場測試前的一道篩選。
2. 用世界模型建立帶預設標籤的樣本
我們將 NVIDIA Cosmos3-Nano Generator 部署成推理服務,在同一次推理中產生影片與聲音,不另外後製音軌。這讓我們可以用提示詞嘗試建立「畫面正常、聲音異常」的樣本,再經人工檢查確認生成內容是否符合設定。
以此為基礎,我們生成了 170 支機房巡檢影片,分成三組:
- 基準組:50 支正常影片,50 支明顯異常,如冒煙、起火、漏水、電弧、機櫃傾倒
- 細微組:35 支描繪細微異常的影片,加上 15 支正常影片
- 聲音組:20 支設定為畫面正常、聲音異常的影片;評估時另從前兩組取 65 支提示詞未指定異常聲響的影片,以其環境音作為負樣本
2.1 一次生成影片與聲音
在這套流程中,我們使用 Cosmos3-Nano Generator 負責依提示詞生成影片,並使用 Cosmos3-Nano Reasoner 進行視覺判讀。生成端對外只有一個介面:送一段提示詞進去,拿到一支約 2.5 秒的 720p 短片,音軌已經在裡面。
170 支影片用同一組生成參數,只有提示詞和隨機種子不同,回頭對照時不必考慮其他變因。
2.2 提示詞怎麼寫
每支影片的提示詞分兩段:前段描述場景,後段描述聲音。三組的寫法不同,下面的範例只列場景那段。
基準組寫正常機房,或是明顯的異常場景。正常和異常各 25 個提示詞,每個提示詞跑 2 個隨機種子,各得 50 支。一個異常提示詞的場景段像這樣:
A swollen leaking UPS battery venting fumes in the battery room.
細微組寫的就是第 1 節提到的那類異常:單顆琥珀色燈、門沒關緊、缺盲板,再加上進氣濾網積塵、結露、忘記帶走的工具。另外 15 支寫成正常畫面,讓這組也有負樣本。
聲音組把場景寫成正常,把聲音那段寫成故障聲。故障聲涵蓋軸承、變壓器、繼電器這類低頻機械聲,以及高頻尖嘯、寬頻嘶聲、脈衝聲。
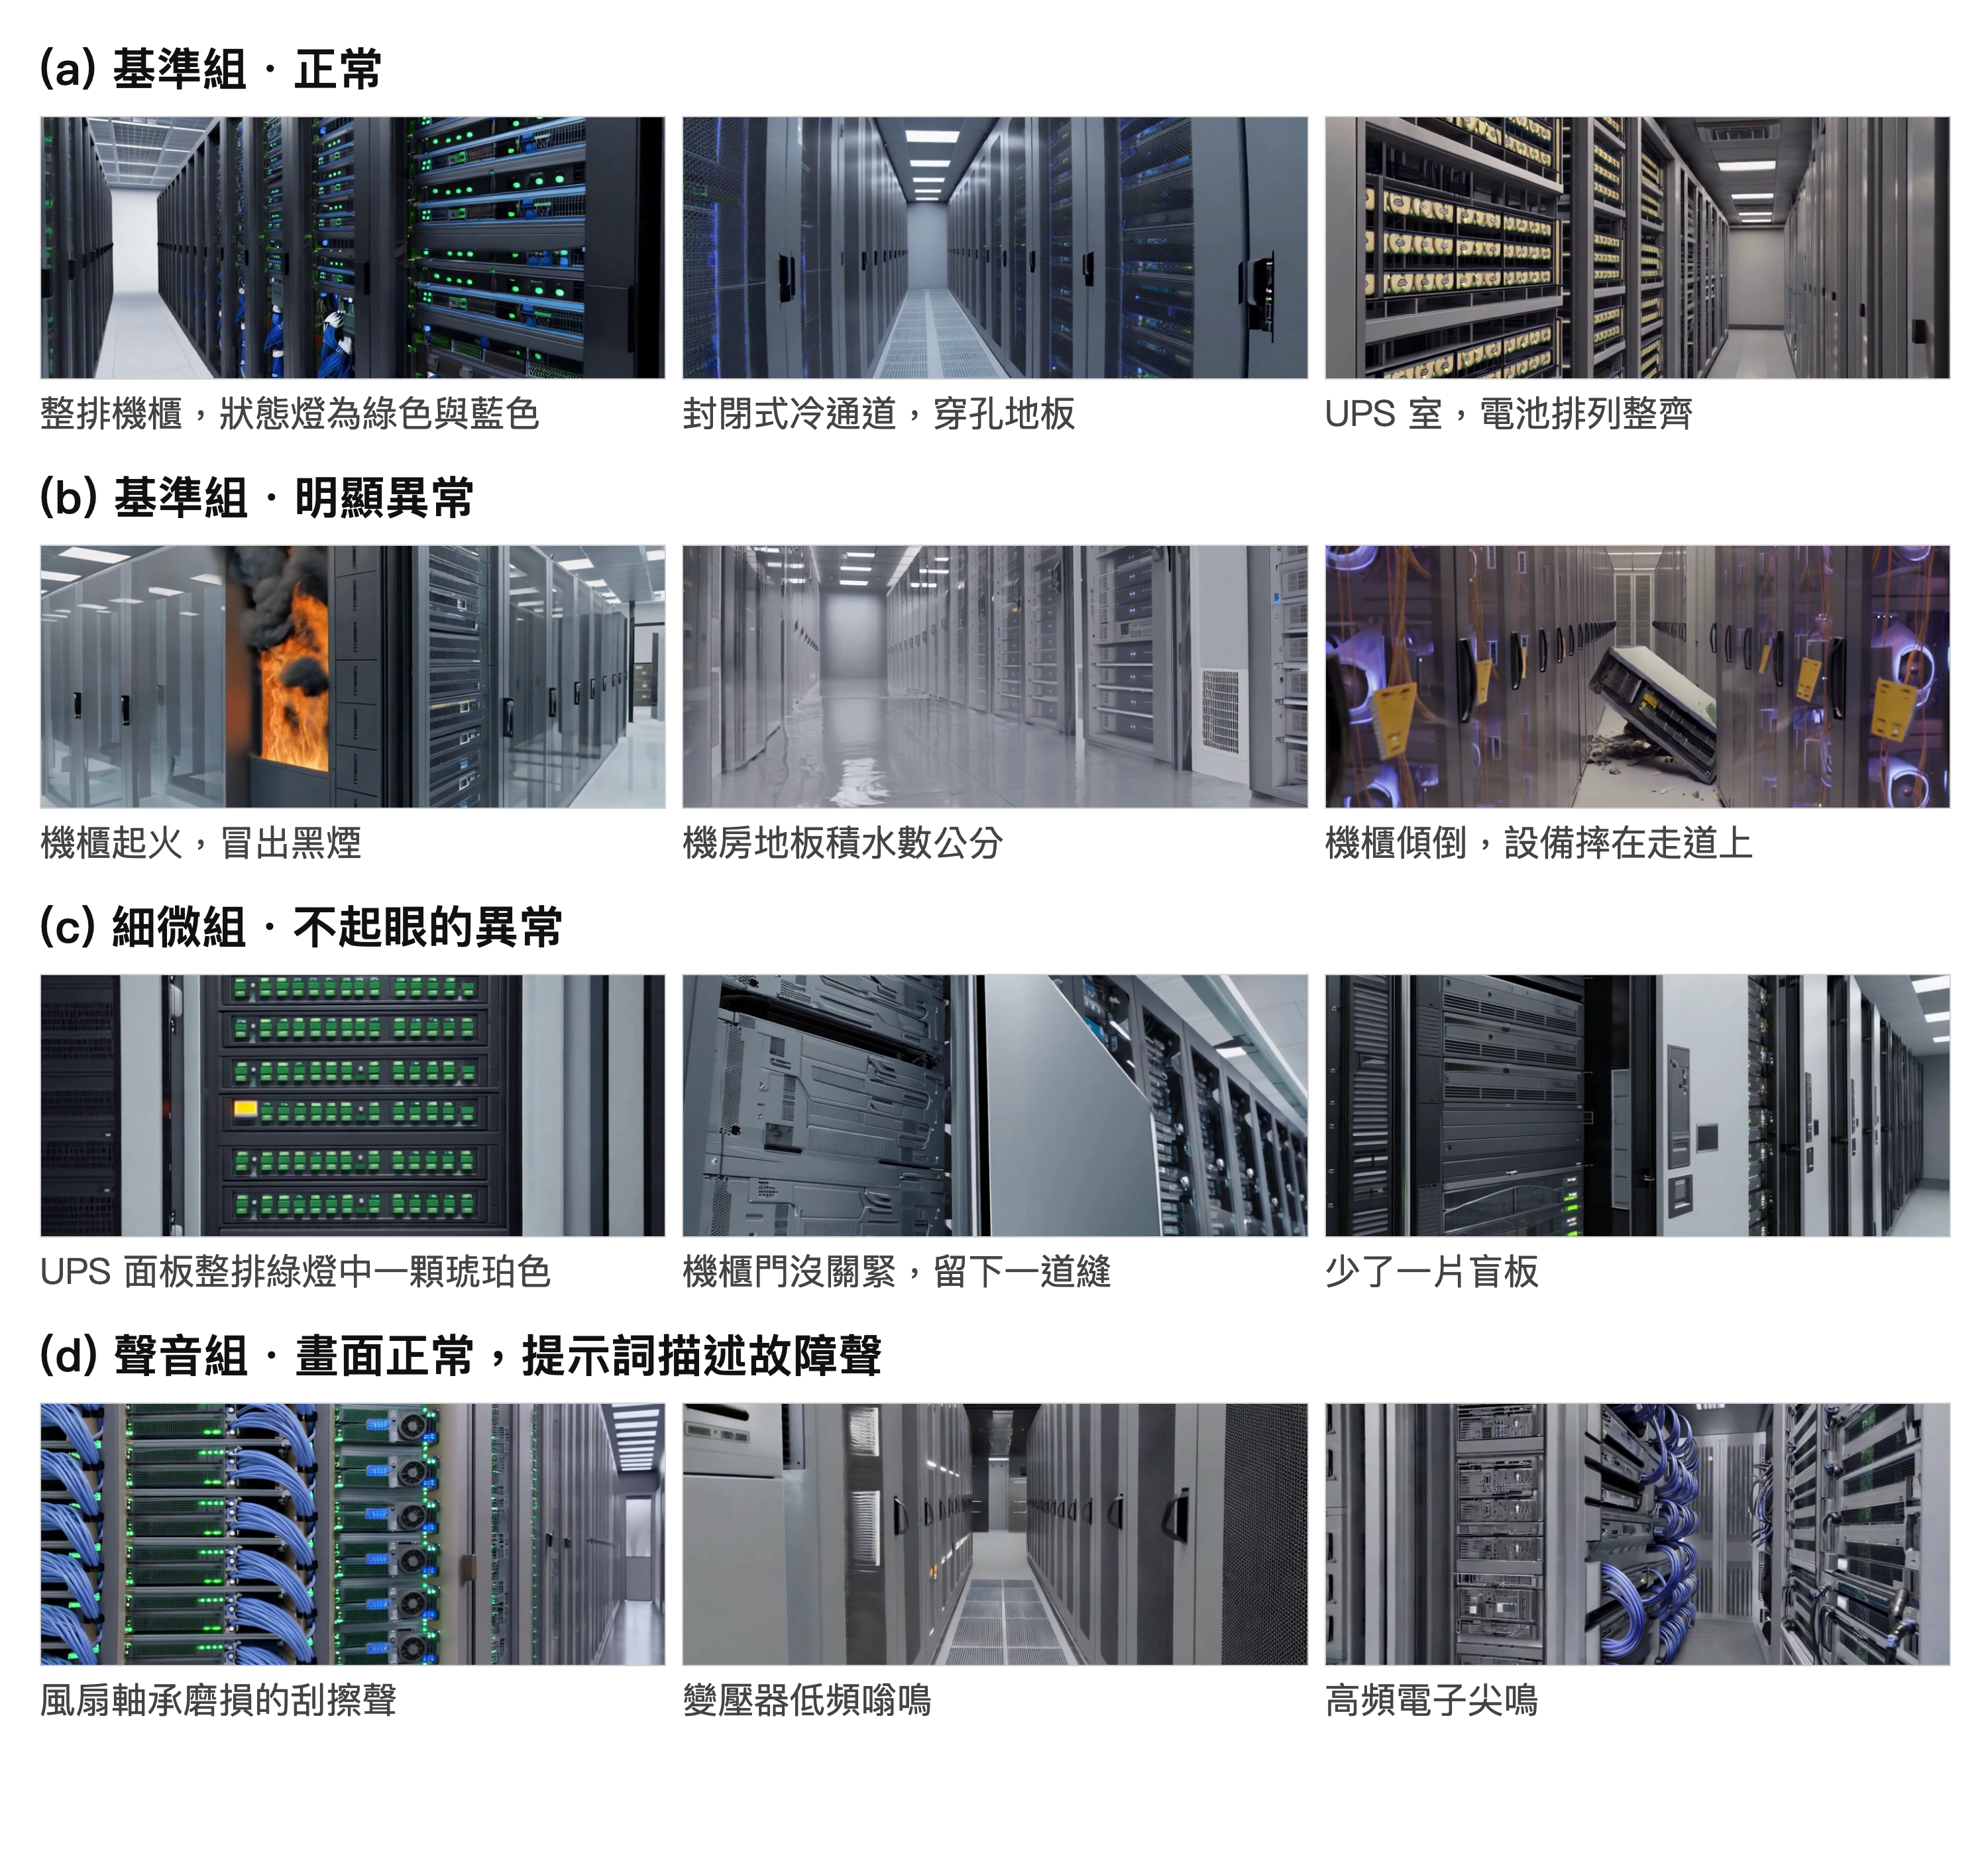
上圖是從檢視影片截出的各組影格,已裁去疊字列。細微組那一排最能說明這批資料的難處:琥珀色的燈、門縫、缺掉的盲板,人眼一秒看到,但在整個畫面裡只占很小一塊。
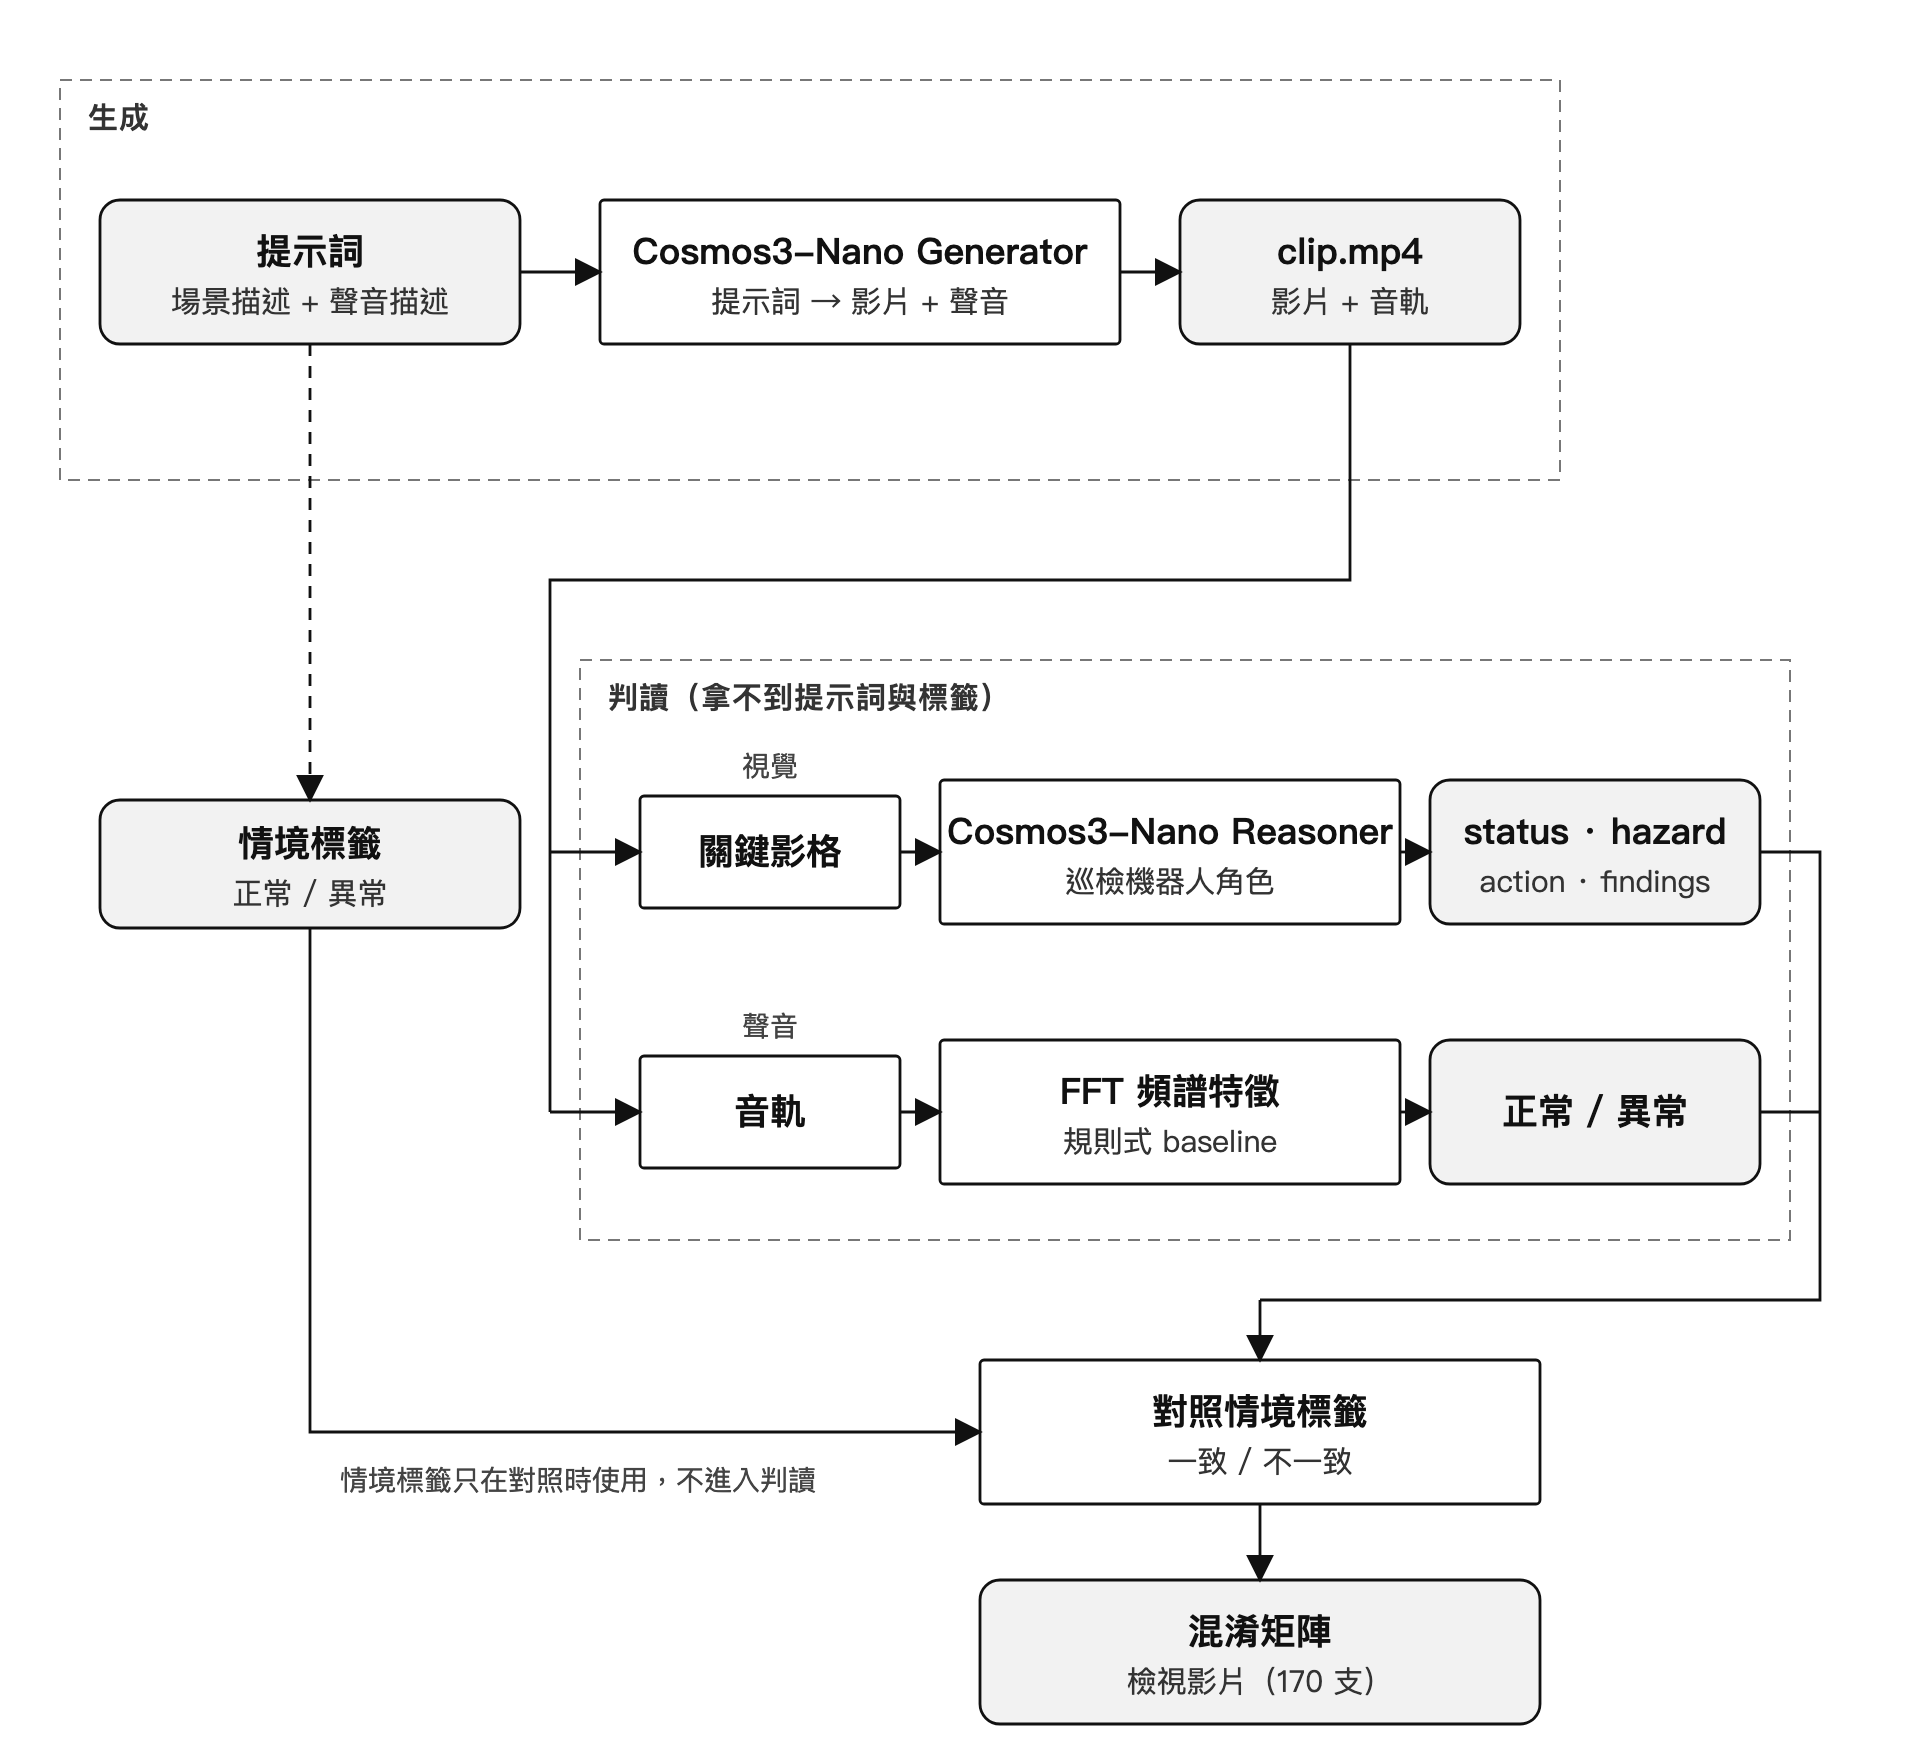
正常或異常標籤取自提示詞,代表這支影片原先要生成的情境,不等同於真實場域量測所得的 ground truth。下文稱它為情境標籤。
生成和判讀是分開的。提示詞只交給 Generator;判讀時,Reasoner 只看畫面,FFT 規則只分析波形,兩者皆無法取得提示詞。以下數字只反映這套流程在合成資料上的表現。
3. 從生成到判讀
整條流程分成生成和判讀兩段,中間只靠同一支影片檔銜接;情境標籤留到最後對照那一步才用。影片進到判讀端之後,視覺與聲音分開處理。
3.1 視覺判讀
視覺判讀只跑基準組和細微組;聲音組的 20 支不進 Reasoner 計分,只走 3.2 的聲音判讀。視覺端先從影片抽關鍵影格,交給 Cosmos3-Nano Reasoner。我們給 Reasoner 一個巡檢機器人的角色設定,要求它以固定格式回傳四個欄位:status 標示正常還是異常,hazard 是危害種類,action 是處置建議,findings 是它在畫面上看到的東西。
我們的情境標籤只有正常和異常兩種,所以計分只比對 status。hazard 和 action 沒有對應的標籤,疊在檢視影片上,看的時候一起核對。
3.2 聲音判讀
聲音端抽出音軌,先以 FFT 頻譜特徵建立一個規則式異常偵測 baseline:算出波峰因數、主峰頻率、高頻成分等幾個特徵,用門檻規則分成正常或異常,沒有用學習式模型。這一步的目的,是先驗證整套多模態流程能走通,判讀模組之後可以逐步替換或升級。
門檻是拿兩類資料一起校準的:聲音組 20 支的故障聲,加上前兩組 65 支影片的環境音,這些影片的提示詞沒有指定異常聲響。校準時只保留能分開兩類的特徵。
3.3 對照、計分與檢視
判讀完成後,把每支影片的判讀結果和情境標籤對起來,整理成混淆矩陣。這裡算出來的數字,是判讀結果與情境標籤的一致性,不是真實場域的偵測準確率。
100 支基準組包含 50 支正常與 50 支明顯異常影片,其中 96 支的 Reasoner 判定,和生成時設定的情境標籤一致(96%)。這項數字反映的,是本次合成資料上的端到端一致性。
| Reasoner 判定:正常 | Reasoner 判定:異常 | |
|---|---|---|
| 情境標籤:正常(50) | 50 | 0 |
| 情境標籤:異常(50) | 4 | 46 |
不一致的 4 支,都落在情境標籤為異常的那一半。本文先以 100 支基準組驗證端到端流程;細微組與聲音組主要用於建立後續壓力測試資料,本文暫不將其結果作為模型效能指標。
每支影片最後都疊上提示詞、判讀結果及情境標籤,音軌保留生成時的聲音,再合成一支 7 分 12 秒的檢視影片。這種呈現方式比只看統計表更直接,也方便逐支回頭檢查生成內容是否符合提示詞。
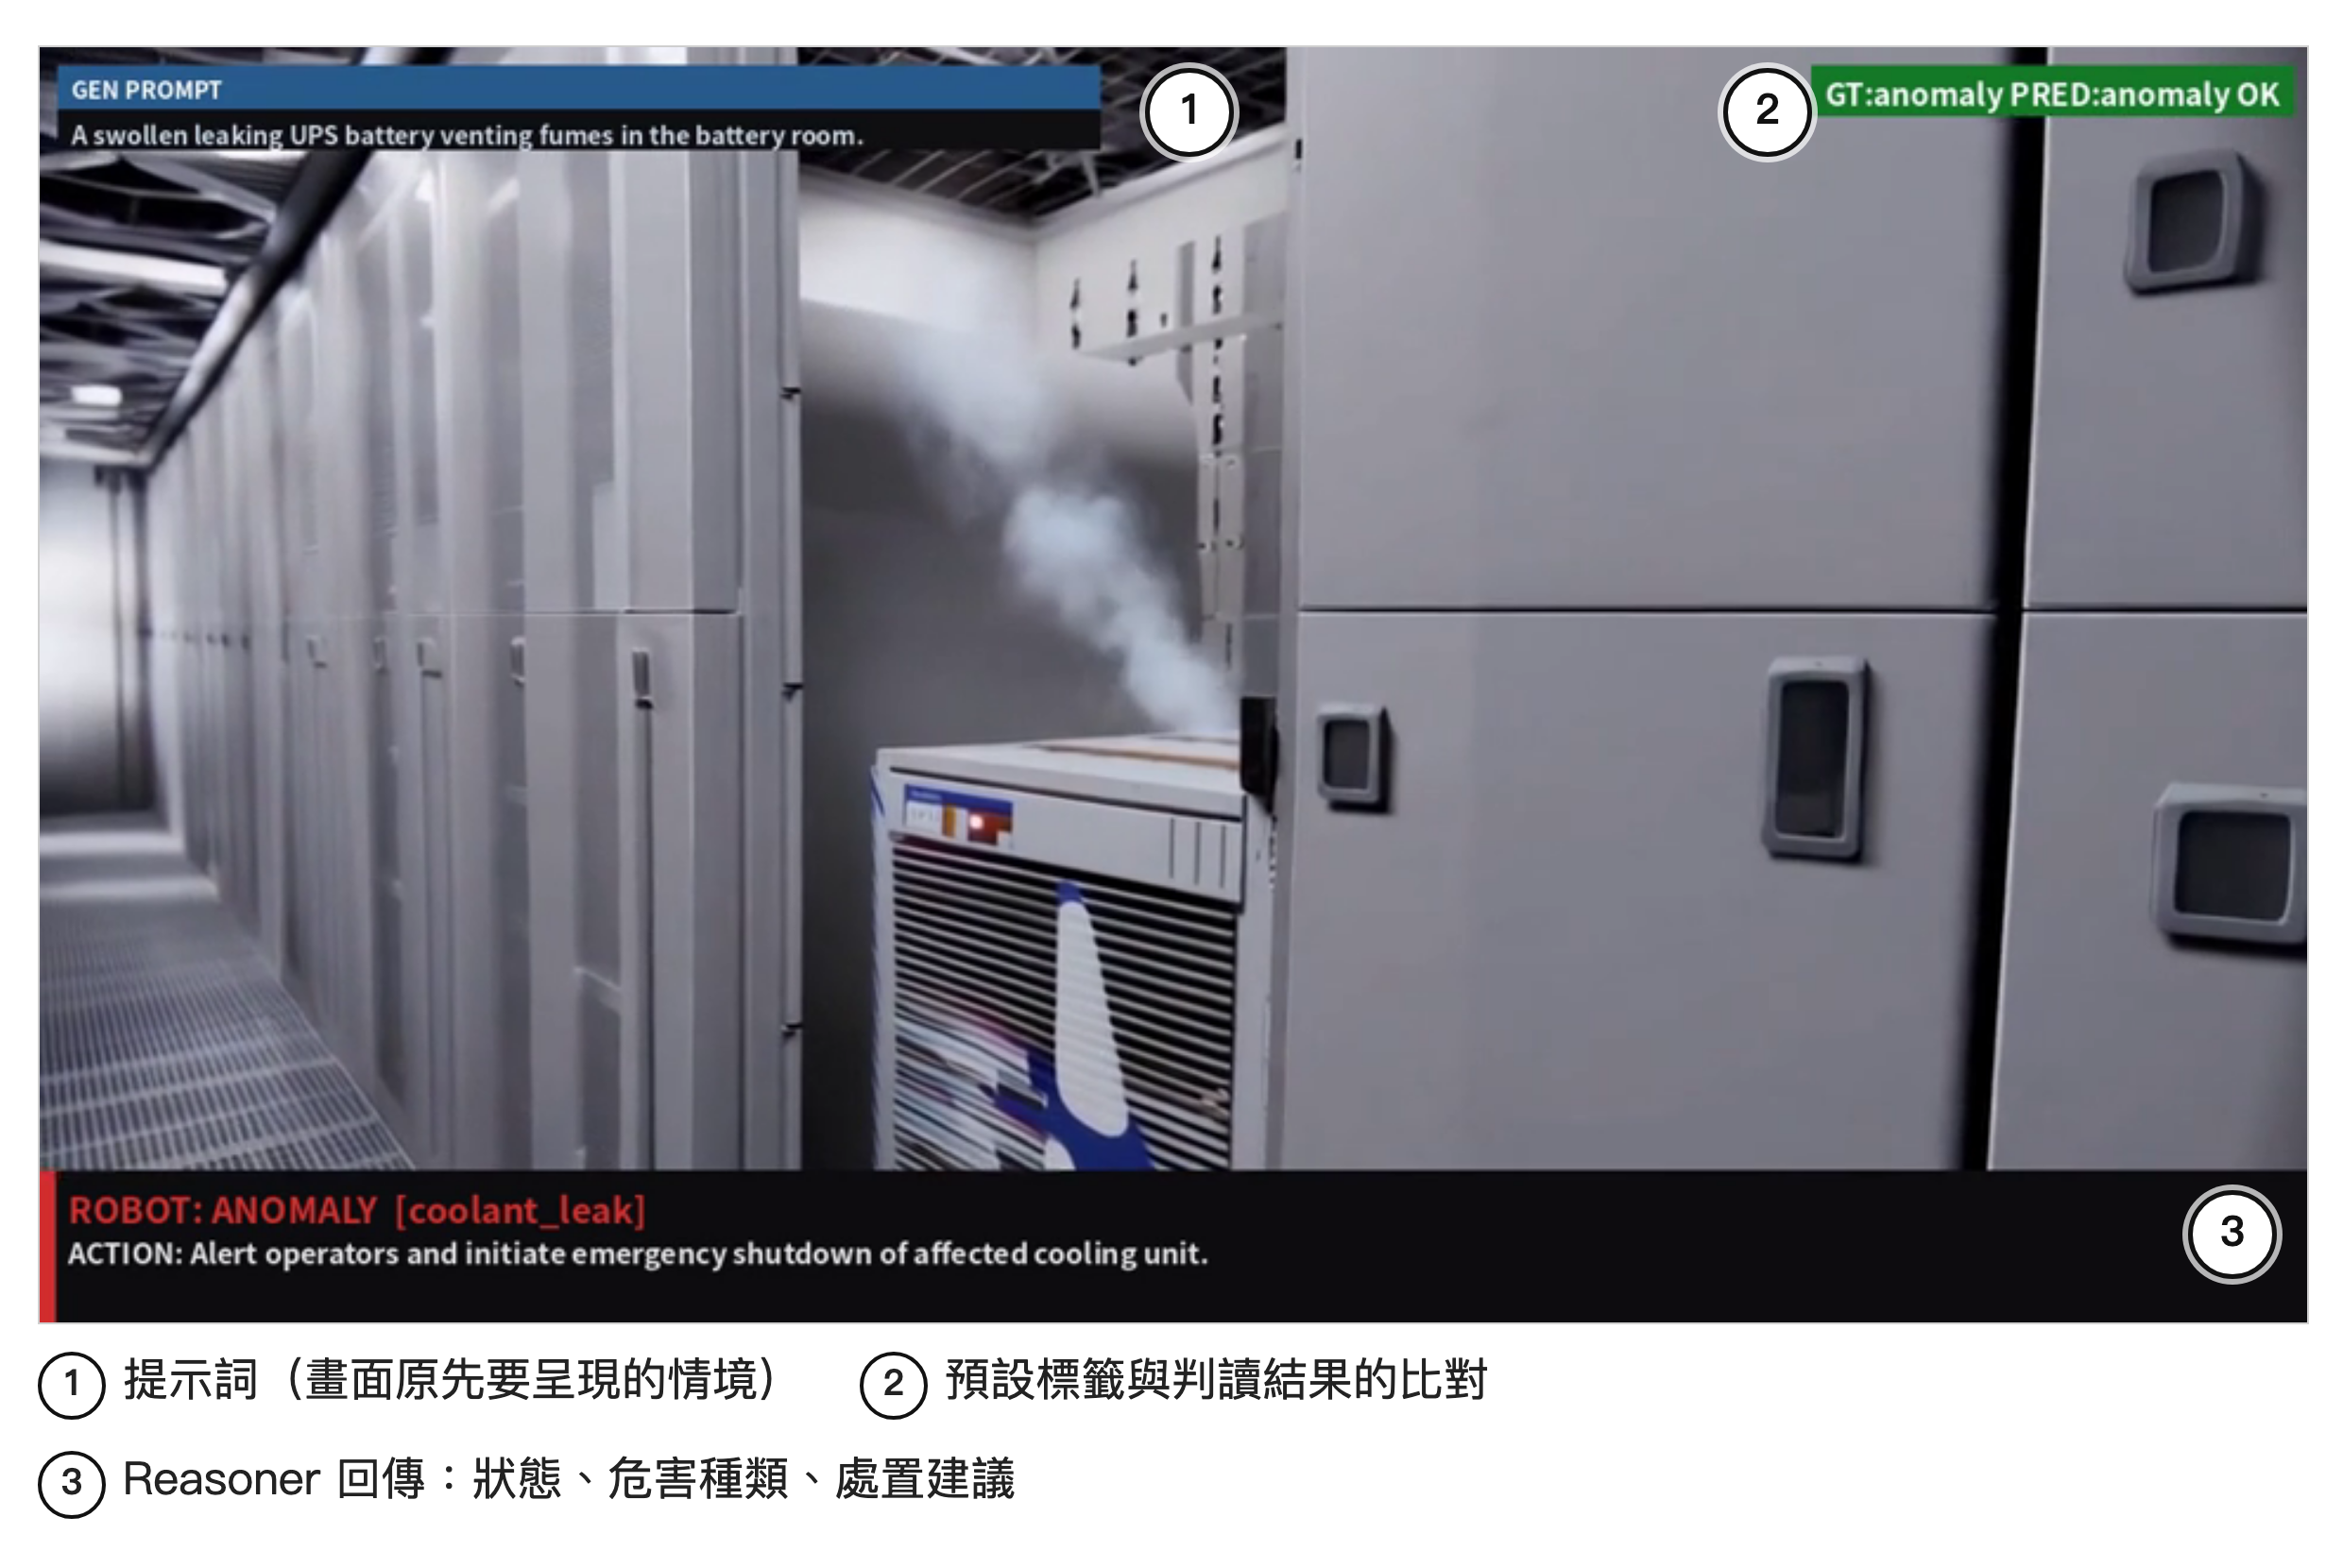
這一格也說明 hazard 為什麼要另外用人看。提示詞寫的是 UPS 電池鼓脹漏液冒煙,畫面裡冒煙的卻是一台像空調機組的機器;Reasoner 判為異常,危害種類標成 coolant_leak,也就是冷卻液外漏。正常還是異常判對了,種類和提示對不上,但原因可能在生成端而不是判讀端。這也是為什麼要逐支回看生成內容是否符合提示詞。右上角的 GT 是情境標籤,不是現場量測的 ground truth。
4. 這套流程能做什麼
這次實作的重點不是用合成資料取代現場資料,而是先把少見、難蒐集的情境,整理成可重複執行的測試集。分工很清楚:Generator 建立測試世界,提示詞定義預期情境,人工確認生成是否忠實,Reasoner 負責視覺理解,FFT 規則作為聲音異常的 baseline,固定下來的資料集,留給之後的回歸測試。提示詞可以控制情境與異常類型,同一套判讀流程也能反覆執行,適合在模型或規則更新後快速比較結果。
合成資料仍有明確限制。提示詞寫了某項異常,不代表生成的影片一定忠實呈現;所有樣本都需要人工檢查,正式評估也必須加入真實機房影像與錄音。另一個限制在取樣:目前視覺判讀採關鍵影格取樣,因此短暫出現或發生於取樣間隔中的異常可能被漏掉;這類錯誤需要與 Reasoner 本身的判讀錯誤分開分析。往後分析漏判時,要分三層看:Generator 是否真的生成了那個異常,關鍵影格是否抓到它,Reasoner 是否正確理解畫面。不能把所有錯誤都歸給 Reasoner。
結語
這次實作產出了 170 支影音樣本,也把場景生成、視覺判讀、聲音分析與結果彙整接成一套可重複執行的流程。模型或判讀規則更新後,可以用同一批資料重新測試,不必每次從頭準備素材。
對 AIDC 巡檢而言,我們目前對世界模型的定位相當明確:先建立難以蒐集的測試情境,用來檢查流程、找出問題,再進入真實場域驗證。合成資料不取代現場資料,但能讓 Physical AI 在部署前多一道可控的測試。